Покупатель нажимает «Оплатить», и интернет-магазин обращается к платёжному сервису. Сервис завис: не отвечает и не сообщает об ошибке. Через несколько секунд у магазина перестаёт открываться даже каталог, которому платежи не нужны.
Почему чужая зависшая программа останавливает твою и как этому помешать?
Короткий ответ: между программой и сервисом ставят небольшую часть кода, предохранитель (circuit breaker). Он передаёт обращения дальше и считает неудачи. Когда неудач становится слишком много, он перестаёт обращаться к сервису и сразу отвечает ошибкой, поэтому никто не ждёт зря. Через некоторое время он осторожно проверяет, ожил ли сервис.
Дальше пойдём так. Сначала разберём, чем опасно обращение по сети и как зависание расходится по соседним сервисам. Затем прочитаем короткий код предохранителя на Ruby; знать Ruby заранее не нужно. После этого научим его восстанавливаться самостоятельно. В конце посмотрим, что меняется в настоящих системах и что делать программе, получившей отказ. Статья пересказывает заметку Мартина Фаулера о предохранителях.
Чем вызов по сети опаснее обычного
Сначала посмотрим, чем обращение к другой программе отличается от обращения к функции внутри своей.
Программы часто обращаются к другим программам, которые работают в других процессах и, вероятно, на других машинах в сети. Процесс это запущенная программа со своей памятью. Такое обращение называют удалённым вызовом (remote call). Обычный вызов функции внутри своей программы называют вызовом в памяти (in-memory call): он выполняется в том же процессе, поэтому между сторонами нет сети.
Одно из главных отличий в том, что удалённый вызов может закончиться неудачей или зависнуть без ответа. Вызов в памяти тоже может завершиться ошибкой или зависнуть, например в бесконечном цикле, но он не теряется на другой машине. При удалённом вызове вызывающая программа может просто не получить ничего и не узнать почему.
Поэтому ожидание ограничивают сроком. Таймаут (timeout) это предел ожидания: «жду ответа не дольше этого времени, потом считаю вызов неудачным». Сторону, которая вызывает, будем называть клиентом (client), а сторону, которая должна ответить, поставщиком (supplier). В нашем начальном случае магазин это клиент, платёжный сервис это поставщик.
Итак, удалённый вызов может долго ничего не вернуть, и таймаут ограничивает это ожидание. Но почему ожидание одного вызова становится проблемой всей системы?
Как один зависший сервис останавливает соседние
Пока клиент ждёт, он занимает то, чего у него ограниченное количество.
Такие ограниченные вещи называют ресурсами. Для расчёта возьмём один ресурс: работника, то есть часть программы магазина, которая обрабатывает один запрос покупателя и на это время занята.
Условный пример, числа придуманы для расчёта. У магазина 100 работников, таймаут вызова платёжного сервиса 30 секунд, на оплату приходит 10 запросов в секунду. Пока сервис здоров и отвечает за 0,1 секунды, занят в среднем 1 работник (10 × 0,1). Когда сервис завис, каждый запрос держит работника полные 30 секунд. Занятых становится на 10 больше каждую секунду, и через 10 секунд заняты все 100, хотя первый таймаут наступит только на тридцатой секунде. Общее правило: при зависшем поставщике занято столько работников, сколько даёт скорость запросов × срок ожидания; если их нужно больше, чем есть, они кончатся.
Покупатель открывает каталог, но свободного работника нет, и исправный каталог перестаёт отвечать. Теперь для других программ, обращающихся к магазину, зависшим поставщиком стал сам магазин, и у них начинается то же самое. У популярного поставщика клиентов много, и с каждым происходит то же самое. Так много клиентов одного неотвечающего поставщика исчерпывают критически важные ресурсы, и отказ расходится по нескольким системам. Это называют каскадным отказом (cascading failures).
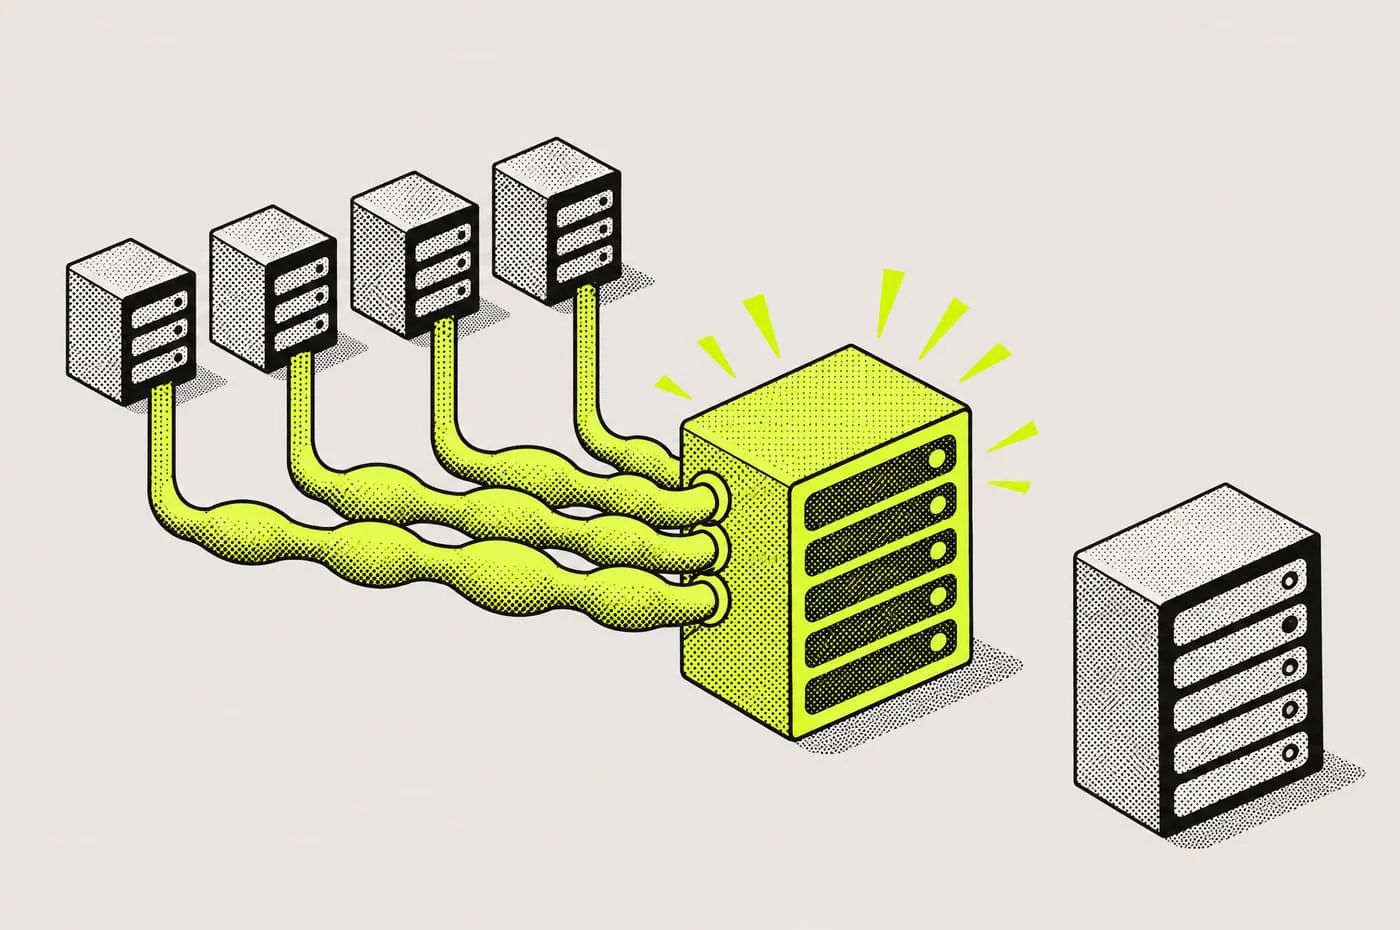
Схема собирает этот путь в четыре шага, от здорового сервиса до другой программы, которая ждёт уже магазин.
- Клиенты ждут
- Зависший сервис
- Каталог без ресурсов
Описание словами
Слева несколько клиентов, каждый держит вызов к одному сервису. Сервис завис, поэтому вызовы копятся и держат ресурсы клиентов. Справа отдельная часть системы, которой эти ресурсы нужны, но ей ничего не досталось: так исправный каталог перестаёт отвечать, а зависание расходится дальше.Кажется, что таймаута достаточно. На деле он ограничивает один вызов, а каждый следующий снова ждёт полный срок. В нашем расчёте таймаут ни разу не успел истечь до того, как кончились работники. При малом числе вызовов он спас бы магазин: разницу покажет задание ниже.
Как защиту от такого каскада паттерн Circuit Breaker сделал широко известным Майкл Нейгард (Michael Nygard) в книге Release It!. Фаулер называет её отличной книгой. Паттерн здесь значит проверенный приём построения программ.
Ожидание занимает ресурсы быстрее, чем таймауты их освобождают. Как перестать ждать поставщика, который, скорее всего, не ответит?
Что делает предохранитель
Если поставщик уже несколько раз не ответил, новый вызов, вероятно, тоже закончится неудачей. Предохранитель использует это простое наблюдение, и основная идея у него очень простая.
Вызов поставщика, который мы хотим защитить, называют защищённым вызовом (protected call). Его оборачивают в объект-предохранитель: клиент обращается к предохранителю, а тот уже к поставщику. Объект это часть программы, у которой есть свои данные и свои действия. Предохранитель следит за неудачами. Когда неудачи доходят до заданного порога (threshold), предохранитель срабатывает (trips). После этого все дальнейшие вызовы предохранителя сразу возвращают ошибку, а защищённый вызов вообще не выполняется. Обычно при срабатывании также нужно какое-то оповещение от монитора, то есть части программы, которая сообщает людям о происходящем (monitor alert).
Название взято у электрического автомата в щитке, который при перегрузке разрывает цепь: так по-английски и называют автоматический выключатель. Аналогия ограничена: автомат защищает провода от перегрева, а программный предохранитель экономит ожидание и нагрузку. Плавкий предохранитель в быту после срабатывания меняют, а наш можно включить снова и даже научить делать это самостоятельно.
Из аналогии взяты и названия состояний. Кажется, что «открыт» значит «проход открыт». На деле наоборот: закрытый предохранитель (closed) похож на замкнутую цепь, ток идёт и вызовы проходят к поставщику. Открытый предохранитель (open) похож на разорванную цепь, поэтому вызовы к поставщику не идут. В коде ниже :closed ведёт к настоящему вызову, а :open сразу к ошибке.
Как выглядит срабатывание по шагам
На схеме три участника: client, circuit breaker и supplier. Время идёт сверху вниз, сплошная стрелка это вызов, пунктирная это ответ или ошибка.

Описание словами
Три участника: client, circuit breaker, supplier; время идёт сверху вниз; сплошная стрелка это вызов, пунктирная это ответ или ошибка. Заход 1, связь в порядке: client вызывает circuit breaker, тот вызывает supplier, ответ возвращается по той же цепочке, клиент получает обычный ответ. Затем возникает connection problem между circuit breaker и supplier, она длится до конца схемы. Заход 2: вызов уходит от client через circuit breaker к supplier, ответа нет; circuit breaker получает timeout! и передаёт client ошибку timeout!. Заход 3: клиент снова ждёт срок таймаута, снова timeout! у circuit breaker и timeout! у client; затем circuit breaker срабатывает сам у себя: стрелка к самому себе trip. Заход 4: client вызывает circuit breaker и сразу получает ошибку circuit open!, к supplier вызова нет, никто не ждёт. Всего на схеме четыре подписи timeout!: две между circuit breaker и supplier, две между circuit breaker и client. В этой иллюстрации срабатывание наступает после двух таймаутов.В заходе 1 связь в порядке, и клиент получает обычный ответ. После неполадки связи (connection problem) заходы 2 и 3 идут одинаково: вызов уходит к supplier, ответа нет, и клиент получает ошибку timeout!. В конце захода 3 circuit breaker срабатывает сам у себя: trip. В заходе 4 к supplier вызова нет, и клиент сразу получает ошибку circuit open!.
В заходе 3 клиент ждал срок таймаута, а в заходе 4 ошибка приходит сразу. В этом польза для клиента; польза для поставщика появится позже. Здесь срабатывание наступает после двух таймаутов, это просто иллюстрация: в коде ниже порог равен пяти.
Идея понятна: считаем неудачи и после порога перестаём вызывать поставщика. Как это записать в коде?
Как это записано в коде
Фаулер показывает простой пример на Ruby, защищающий от таймаутов. Разберём его по кускам вместе с нужным синтаксисом Ruby.
Как создаётся предохранитель
Предохранитель настраивают блоком (Lambda), в котором записан защищённый вызов. Блок это кусок кода, который передают, чтобы выполнить позже.
Rubycb = CircuitBreaker.new {|arg| @supplier.func arg}
CircuitBreaker.new создаёт новый объект. В фигурных скобках записано: получив значение arg, вызови у поставщика функцию func с этим значением. Значок @ в Ruby отмечает данные, принадлежащие объекту. Предохранитель cb запоминает этот блок и пока ничего не вызывает.
При создании предохранитель сохраняет блок, задаёт параметры порогов, таймаутов и наблюдения и переводит себя в закрытое состояние. Подпись class CircuitBreaker... у Фаулера значит, что показан отрывок из этого класса, то есть описания таких объектов.
class CircuitBreaker…
Ruby attr_accessor :invocation_timeout, :failure_threshold, :monitor def initialize &block @circuit = block @invocation_timeout = 0.011 @failure_threshold = 52 @monitor = acquire_monitor reset3 end
- Срок одного вызова: 0.01 секунды, то есть 10 миллисекунд.
- Порог: после пяти неудач подряд цепь размыкается.
- Счётчик неудач начинается с нуля.
Строка attr_accessor разрешает читать и менять три настройки снаружи. Слово def начинает метод, то есть функцию объекта, а end его заканчивает. Метод initialize выполняется при создании объекта. Запись &block принимает переданный блок и делает его значением, поэтому его можно сохранить в @circuit. Срок вызова @invocation_timeout равен 0.01, в Ruby это секунды, то есть 10 миллисекунд. Порог @failure_threshold равен 5. Метод acquire_monitor в заметке не показан: он как-то получает монитор. Вызов reset обнуляет счётчик.
Деталь. значения здесь учебные. Для настоящей сети 10 миллисекунд могут оказаться меньше обычного времени ответа; срок подбирают под конкретного поставщика.
Что происходит при вызове
Вызов предохранителя выполнит блок, если цепь закрыта, и вернёт ошибку, если открыта. Клиент при этом выглядит просто:
Ruby# client code aCircuitBreaker.call(5)
Здесь aCircuitBreaker это такой же предохранитель, как cb выше, просто под другим именем. Клиент передаёт значение 5 и не знает, идёт ли вызов на самом деле к поставщику. Внутри предохранителя это устроено так.
class CircuitBreaker…
Ruby def call args case state when :closed begin do_call args rescue Timeout::Error record_failure raise $! end when :open then raise CircuitBreaker::Open else raise "Unreachable Code" end end def do_call args result = Timeout::timeout(@invocation_timeout) do @circuit.call args end reset return result end
Прочитаем call сверху вниз. case state выбирает ветку по текущему состоянию; как метод state его определяет, покажем чуть ниже. Слова с двоеточием, такие как :closed, это просто имена-метки. В ветке :closed выполняется do_call. Двойное двоеточие указывает имя внутри класса или модуля, то есть именованного набора кода: Timeout::Error это ошибка таймаута из модуля Timeout. Конструкция begin … rescue Timeout::Error значит: «попробуй, а если случится ошибка таймаута, выполни следующее». В этом случае record_failure записывает неудачу, а raise $! снова поднимает ту же ошибку ($! в Ruby хранит текущую ошибку), поэтому клиент узнаёт о таймауте.
Команда raise прерывает выполнение и передаёт ошибку вызвавшему коду. В ветке :open она сразу поднимает ошибку CircuitBreaker::Open, и блок не вызывается. Ветка else с текстом "Unreachable Code" это страховка: метод state возвращает только два значения, и сюда выполнение попасть не должно.
Метод do_call выполняет сохранённый блок через @circuit.call args внутри Timeout::timeout(@invocation_timeout), то есть с пределом времени; do … end здесь это ещё одна запись блока. Если блок успел, reset обнуляет счётчик, и клиент получает результат.
Деталь.
rescueздесь ловит толькоTimeout::Error. Мы запустили код: другая ошибка из блока проходит к клиенту, а счётчик остаётся равным 0.
Как считаются ошибки и определяется состояние
При таймауте счётчик неудач увеличивается, успешный вызов сбрасывает его в ноль.
class CircuitBreaker…
Ruby def record_failure @failure_count += 1 @monitor.alert(:open_circuit) if :open == state end def reset @failure_count = 0 @monitor.alert :reset_circuit end
Запись @failure_count += 1 прибавляет единицу. Оповещение :open_circuit монитор получает, только если после этой неудачи состояние стало :open.
Деталь.
do_callвызываетresetпосле каждого успеха, поэтому при запуске:reset_circuitприходил и тогда, когда состояние не менялось. В настоящей системе такое стоит отфильтровать, иначе важные сообщения утонут.
Состояние предохранитель определяет, сравнивая счётчик с порогом.
class CircuitBreaker…
Ruby def state (@failure_count >= @failure_threshold) ? :open : :closed end
Запись условие ? a : b значит «если условие верно, то a, иначе b». Состояние нигде не хранится, оно каждый раз вычисляется из счётчика и порога. Значок >= значит «больше или равно», поэтому открытие наступает ровно на пятой неудаче.
Разбор: пять таймаутов подряд
Исходное состояние: счётчик 0, порог 5, срок 0.01 секунды, поставщик завис. Таблица получена запуском кода Фаулера на Ruby 3.3, с заглушками, то есть простыми заменами того, что в заметке не показано.
| Вызов | Состояние до | Что происходит | Счётчик после | Состояние после | Клиент получает, примерно за |
|---|---|---|---|---|---|
| 1 | :closed |
Блок выполняется, срок истекает | 1 | :closed |
Timeout::Error, 10 мс |
| 2 | :closed |
То же | 2 | :closed |
Timeout::Error, 10 мс |
| 3 | :closed |
То же | 3 | :closed |
Timeout::Error, 10 мс |
| 4 | :closed |
То же | 4 | :closed |
Timeout::Error, 10 мс |
| 5 | :closed |
То же, 5 >= 5, монитору уходит :open_circuit |
5 | :open |
Timeout::Error, 10 мс |
| 6 | :open |
Блок не выполняется | 5 | :open |
CircuitBreaker::Open, почти сразу |
Пятый клиент ещё ждал и получил ошибку таймаута, а шестой уже не ждал. Поставщик увидел ровно 5 вызовов, сколько бы их ни было потом. Сравни со случаем, где между неудачами был успех: неудача, неудача, успех, неудача, неудача, неудача. Счётчик идёт 1, 2, 0, 1, 2, 3, и предохранитель остаётся закрытым, потому что успех стирает накопленное.
Мы так и не сказали, как предохранитель снова закрывается. Что будет, когда поставщика починят?
Как предохранитель восстанавливается сам
Простой предохранитель перестаёт делать защищённый вызов, пока цепь открыта, но когда всё наладится, сброс потребует вмешательства извне. Мы проверили: поставщик снова работает, а код продолжает возвращать CircuitBreaker::Open, пока кто-то не вызовет reset.
Для электрических автоматов в зданиях такой подход разумен: человек приходит к щитку и включает автомат. Программный предохранитель может сам определить, что вызовы снова работают. Для этого он после подходящего интервала снова пробует защищённый вызов и сбрасывается, если попытка удалась.
Какие состояния и переходы появляются
Появляется третье состояние, полуоткрытое (half open). Оно значит, что цепь готова сделать настоящий вызов как пробу, чтобы узнать, устранена ли проблема. Время, которое открытый предохранитель выжидает перед пробой, будем называть сроком сброса (reset timeout). Не путай его с таймаутом вызова: тот ограничивает ожидание ответа, а срок сброса задаёт паузу до пробы. На схеме три состояния, Closed, Open и Half Open, и семь переходов между ними. Сплошная стрелка значит вызов и его исход. Пунктирная всего одна, reset timeout: в Half Open ведёт прошедшее время, а не вызов.

Описание словами
Три состояния: Closed, Open, Half Open. Семь переходов. Из Closed в Closed: success. Из Closed в Closed: fail [under threshold]. Из Closed в Open: fail [threshold reached]. Из Open в Open: call / raise circuit open. Из Open в Half Open: reset timeout. Из Half Open в Open: fail. Из Half Open в Closed: success. Сплошная стрелка значит вызов и его исход, пунктирная значит, что прошло время. Пунктирная только одна, reset timeout: в Half Open ведёт время, а не вызов.Таблица объясняет каждую подпись схемы.
| Откуда | Куда | Подпись на схеме | Что это значит |
|---|---|---|---|
Closed |
Closed |
success |
Успешный вызов, ничего не меняется |
Closed |
Closed |
fail [under threshold] |
Неудача, порог ещё не достигнут |
Closed |
Open |
fail [threshold reached] |
Неудача, порог достигнут |
Open |
Open |
call / raise circuit open |
Вызов получает ошибку сразу |
Open |
Half Open |
reset timeout |
Прошёл срок сброса |
Half Open |
Open |
fail |
Проба не удалась |
Half Open |
Closed |
success |
Проба удалась |
Кажется, что полуоткрытый значит «пропускает половину вызовов». На деле половины здесь нет: в этом состоянии предохранитель делает настоящий вызов как проверку и по его исходу решает, закрыться или снова открыться.
Что изменилось в коде
Фаулер показывает новую версию отдельным классом ResetCircuitBreaker: это тот же предохранитель, а отрывки содержат только то, что изменилось или дополнено. Для него нужны срок сброса (Фаулер называет его порогом для попытки сброса, a threshold for trying the reset; здесь это порог времени, а не числа неудач) и переменная, где хранится время последней ошибки.
class ResetCircuitBreaker…
Ruby def initialize &block @circuit = block @invocation_timeout = 0.01 @failure_threshold = 5 @monitor = BreakerMonitor.new @reset_timeout = 0.1 reset end def reset @failure_count = 0 @last_failure_time = nil @monitor.alert :reset_circuit end
Срок сброса @reset_timeout равен 0.1 секунды, то есть 100 миллисекунд. Переменная @last_failure_time хранит время последней неудачи, а nil значит «значения нет». Класс BreakerMonitor.new в заметке, как и acquire_monitor, не показан.
class ResetCircuitBreaker…
Ruby def state case when (@failure_count >= @failure_threshold) && (Time.now - @last_failure_time) > @reset_timeout :half_open when (@failure_count >= @failure_threshold) :open else :closed end end
Time.now это текущее время, а разность двух времён даёт секунды. Условия проверяются сверху вниз: если порог достигнут и после последней неудачи прошло больше срока сброса, состояние :half_open; если порог достигнут, но срок не прошёл, :open; иначе :closed. Состояние вычисляется, поэтому к полуоткрытому ведёт просто прошедшее время.
Вызов в полуоткрытом состоянии приводит к пробному вызову. Он либо сбрасывает предохранитель при успехе, либо запускает срок заново при неудаче.
class ResetCircuitBreaker…
Ruby def call args case state when :closed, :half_open begin do_call args rescue Timeout::Error record_failure raise $! end when :open raise CircuitBreaker::Open else raise "Unreachable" end end def record_failure @failure_count += 1 @last_failure_time = Time.now @monitor.alert(:open_circuit) if :open == state end
Ветка when :closed, :half_open обрабатывает пробу тем же кодом, что и обычный вызов. Метод record_failure запоминает время неудачи, и это запускает срок заново. Метод do_call здесь не показан; при запуске мы взяли его из первой версии.
Разбор: неудачная и удачная проба
Исходное состояние: пятая неудача только что случилась, счётчик 5, срок сброса 0.1 секунды, поставщик завис. Время считаем в секундах от этой неудачи. Ход событий снова взят из запуска.
| Момент | Состояние | Действие и причина | Результат |
|---|---|---|---|
| 0.05 | :open |
Срок сброса не прошёл, блок не выполняется | Сразу CircuitBreaker::Open |
| 0.12 | :half_open |
Прошло больше 0.1, поэтому делается проба. Поставщик молчит | Timeout::Error, счётчик 6, время неудачи обновлено |
| сразу после | :open |
Время неудачи только что обновилось, срок считается заново | Сразу CircuitBreaker::Open |
| ещё через 0.12 | :half_open |
Срок снова прошёл. Поставщик уже ответил | Результат, reset, счётчик 0, :closed |
Пока поставщик болен, почти все клиенты получают отказ сразу, а как только он выздоровел, следующая проба возвращает обычную работу без участия человека.
Деталь. простая версия не ограничивает число проб. Пока первая проба идёт, время неудачи не обновилось, поэтому следующие вызовы тоже становятся пробами: из 8 одновременных вызовов до поставщика при запуске дошли все 8. Настоящие библиотеки это ограничивают: например, в библиотеке предохранителей Resilience4j по умолчанию разрешено 10 вызовов в полуоткрытом состоянии, и число настраивается.
Учебный механизм готов, но Фаулер предупреждает, что это простой пример для объяснения. Что на практике считать неудачей?
Какие ошибки должны засчитываться
На практике предохранители дают заметно больше возможностей и настроек. Наш пример реагирует только на таймауты.
Часто предохранители защищают от целого ряда ошибок защищённого вызова, например от сбоев сетевого соединения (network connection failures). Клиент при таком сбое почти не ждёт, но считать его стоит: следующий вызов, вероятно, тоже не удастся. Но не каждая ошибка должна приводить к срабатыванию. Некоторые ошибки это нормальные отказы, и их обрабатывает обычная логика программы.
Случай из нашего магазина: сервис ответил «карта отклонена, не хватает денег». Это сообщение быстрое и точное, а значит, поставщик здоров. В коде такой ответ тоже может прийти как ошибка, поэтому важно, что именно перечислено после rescue. Если такие ответы считать неудачами, пять покупателей подряд с пустыми картами заблокируют оплату всем остальным.
Считать нужно ошибки, говорящие о беде у поставщика. Как решить, что беда наступила?
Чем заменить простой счётчик
В примере применён простой способ: счётчик, который сбрасывается при успешном вызове.
Пусть поставщик не отвечает на каждый второй вызов. При запуске 20 таких вызовов подряд счётчик ни разу не поднялся выше 1, и предохранитель так и остался закрытым, хотя половина вызовов зря ждала таймаут. Каждый успех стирает прошлое.
Более изощрённый подход смотрит на частоту ошибок и срабатывает, например, при доле неудач 50%. В нашем случае он сработает, хотя счётчик молчит. Для этого нужно считать долю на каком-то участке, например за последние вызовы; так делает, например, Resilience4j, где порог по умолчанию как раз 50%, а считать долю он начинает не раньше 100 записанных вызовов, так что 20 ему мало.
Можно также задать разные пороги для разных ошибок, например порог 10 для таймаутов, но 3 для сбоев соединения. Одна из возможных причин: единичный таймаут бывает и при случайной задержке, а неудача соединения чаще говорит о том, что до поставщика вообще не добраться.
Любое такое правило смотрит на завершённые вызовы. Что делать, если беда наступает раньше первого результата?
Что делать, когда вызовов очень много
При большом трафике возникает ещё одна проблема: множество вызовов просто ждёт первоначального таймаута. Посмотрим, почему предохранитель с нашим счётчиком тут опоздает.
Вернёмся к условному расчёту работников магазина. 100 работников заняты через 10 секунд, а первая неудача запишется только на тридцатой секунде, когда истечёт таймаут. Пока счётчик стоит на нуле, предохранитель закрыт и пропускает всех. Он всё же откроется примерно на 30,4 секунды, когда истекут таймауты пяти первых вызовов. Значит, счётчик ограничит провал, но не предотвратит его: каталог к этому моменту простоял около 20 секунд.
Удалённые вызовы часто медленные, поэтому нередко стоит выполнять каждый вызов в отдельном потоке. Поток (thread) это отдельная линия выполнения внутри программы: пока он ждёт сеть, другие потоки работают. Наши работники в настоящей программе часто тоже потоки, только занятые запросами покупателей; дальше мы говорим «работник» о них и «поток» о тех, что выполняют вызов поставщика. Работник передаёт вызов такому потоку и получает future или promise: объект-обещание, который заполнится результатом позже. Работник может и ждать его: тогда польза не в том, что он освобождается, а в том, что ждущих будет не больше, чем потоков в пуле.
Если брать такие потоки из пула потоков (thread pool), можно сделать так, что цепь разрывается при исчерпании пула. Пул это ограниченный набор потоков, которые используют повторно: взял, поработал, вернул. Условный пример: выделим вызовам платёжного сервиса пул из 10 потоков. При 10 запросах в секунду он заполнится за 1 секунду.
Сначала о том, что делает сам пул, без предохранителя. Для вызова сверх 10 свободного потока нет, поэтому программа сразу отказывает ему, и его работник тут же освобождается. Даже если работник с запросом внутри пула всё это время ждёт future, таких работников не больше 10, поэтому около 90 продолжат обслуживать каталог.
Схема кладёт оба случая на одну шкалу времени. На верхней дорожке есть только счётчик неудач: работники кончаются к 10-й секунде, а первая неудача приходит на 30-й. На нижней сигналом служит заполнение пула, и он приходит на 1-й секунде.

Описание словами
Условный пример: 100 работников, 10 запросов в секунду, таймаут 30 секунд, шкала от 0 до 30 секунд с начала зависания. Первая дорожка, только счётчик неудач и 100 общих работников: занятые растут от 0 до 100 к 10-й секунде и остаются на 100; на 10-й секунде заняты все 100, каталогу работника нет, счётчик неудач всё ещё 0; первая неудача только на 30-й секунде. Вторая дорожка, отдельный пул из 10 потоков, цепь разрывается при его заполнении: на 1-й секунде пул заполнен, предохранитель открылся, дальше отказы сразу; занято не больше 10 работников, около 90 работников свободны всё время до 30-й секунды. Сигнал о беде приходит на 1-й секунде вместо 30-й, потому что заполнение пула видно раньше, чем завершится первый вызов.Пул только ограничивает число одновременных вызовов: через 30 секунд потоки освободятся, новые вызовы снова займут их и снова будут ждать, а поставщик будет получать их дальше. Предохранитель добавляет другое: заполнение служит для него сигналом, и он открывается на 1-й секунде. Теперь новые вызовы потоков не занимают и к поставщику не идут, эти 10 потоков освободятся по таймауту и больше не займутся, а монитор получает оповещение.
Что потом закроет цепь? Фаулер этого не описывает, поэтому дальше наш вывод. Потоки освобождаются по таймауту, даже если поставщик всё ещё болен, поэтому свободный пул о выздоровлении не говорит. Если закрыть цепь, как только пул освободился, при 10 запросах в секунду он снова заполнится за 1 секунду и опять простоит 30 секунд в ожидании. Значит, нужна та же проба: выждать срок сброса и сделать настоящий вызов, а цепь закрыть только при его успехе. Срок сброса тут разумно взять больше таймаута, иначе для пробы может не оказаться свободного потока.
Пока клиент ждал ответа. А если он не ждёт вовсе?
Как предохранитель работает с очередью
Наш пример относится к синхронным вызовам: клиент останавливается и ждёт ответа. Но предохранители полезны и для асинхронного взаимодействия (asynchronous), когда клиент оставляет запрос и идёт дальше.
Частый приём здесь: все запросы кладут в очередь, а поставщик забирает их со своей скоростью. Это полезный способ не перегружать серверы. В таком случае цепь разрывается, когда очередь заполнена.
Условный пример: очередь на 1000 запросов, приходит 10 запросов в секунду, поставщик успевает 8. Очередь растёт на 2 в секунду и заполнится за 500 секунд. Тогда предохранитель начнёт сразу отвечать отказом, не добавляя запросы, которые всё равно долго никто не выполнит.
Что здесь закроет цепь? Это снова наш вывод, а не слова Фаулера. Длина очереди видна всё время: когда она опустилась ниже заданного уровня, например до половины, цепь можно закрыть без отдельной пробы. Уровень нужен как запас. При закрытии с первым же уменьшением очередь при 10 и 8 запросах в секунду снова заполнится за секунды, и цепь будет переключаться постоянно: примерно 1 секунду открыта, 4 закрыта. При уровне 500 она открыта около 63 секунд и закрыта около 250. Это один из возможных способов, и он годится, только если запросы уходят из очереди потому, что их обработали. Если поставщик умер, очередь не уменьшается, и цепь остаётся открытой. Счётчика таймаутов ответа тут нет: клиент ответов не ждёт.
Механизмы срабатывания разобраны. Что же предохранитель даёт и чего не даёт?
Что предохранитель даёт сам по себе
Сам по себе предохранитель уменьшает ресурсы, занятые операциями, которые, вероятно, не удадутся. Клиенту не приходится ждать таймаутов, а разорванная цепь снимает нагрузку с поставщика, у которого и так трудности: каждый лишний вызов занимает его ресурсы и мешает ему восстановиться. Разговор шёл об удалённых вызовах, поскольку это распространённый случай, но применять предохранитель можно в любой ситуации, где нужно защитить части системы от сбоев в других её частях. Например, так можно защищать программу от очень медленного диска: это тоже внешняя для неё зависимость.
Кажется, что предохранитель исправляет сбой. На деле он сбой не чинит: поставщик остаётся неисправным, и операция клиента не выполняется. Он только делает отказ быстрым и не даёт ему разойтись. Отсюда два вопроса: кто заметит сбой и что сделает клиент?
Почему за предохранителем нужно следить
Через предохранитель проходят все вызовы этого клиента к поставщику, поэтому он видит неудачи и своё переключение и служит удобной точкой наблюдения.
Любое изменение состояния предохранителя стоит записывать в журнал, то есть в запись событий программы, а сам предохранитель должен показывать подробности своего состояния для более глубокого наблюдения. Его поведение часто даёт хорошее предупреждение о более глубоких проблемах в окружающей системе: например, если одновременно открылись предохранители у разных поставщиков, причина может лежать в общей сети. Сотрудники эксплуатации (operations staff), которые следят за работающими системами, должны иметь возможность вручную вызвать срабатывание или сброс.
Срабатывание вручную позволяет заранее снять нагрузку с поставщика, например при его обслуживании, а ручной сброс возвращает работу после ремонта, не дожидаясь срока.
О сбое узнают люди. А что увидит покупатель?
Что должен сделать клиент после отказа
Предохранитель полезен сам по себе, но клиенты, которые им пользуются, должны реагировать на его отказы. Как и при любом удалённом вызове, нужно решить, что делать при неудаче.
Вопрос такой: операция, которую ты выполняешь, тоже завершается неудачей, или есть обходной путь? У Фаулера два примера. Запрос на авторизацию кредитной карты можно поставить в очередь и обработать позже. Если не удалось получить какие-то данные, можно показать устаревшие данные, которых достаточно для отображения.
Вернёмся к покупателю из начала статьи. Открытый предохранитель отвечает сразу, и магазин может сказать: «Заказ принят, оплату подтвердим позже». Магазин решает, какой риск принять: выбор зависит от цены устаревшего или отложенного результата.
Механизм разобран. Соберём его в одну связную модель.
Вся модель целиком
Программы обращаются друг к другу по сети, и такой вызов может зависнуть без ответа, а причину вызывающая программа не узнает. Поэтому ожидание ограничивают таймаутом, но каждый новый вызов снова занимает ресурс на весь срок. Когда вызовов много, ресурсы кончаются раньше, чем приходят таймауты, и клиент перестаёт отвечать своим клиентам: так появляется каскадный отказ.
Чтобы его остановить, вызов оборачивают в предохранитель, который считает неудачи и после порога срабатывает. Открытый предохранитель не выполняет защищённый вызов и сразу отвечает ошибкой, поэтому новые вызовы не занимают ресурсы клиента и не нагружают поставщика, которому лишние вызовы мешают восстановиться. Чтобы не ждать человека, через срок сброса предохранитель становится полуоткрытым и делает настоящий вызов как пробу: успех закрывает его, неудача запускает срок заново.
На практике предохранители часто выбирают, какие ошибки считать, и могут смотреть на долю ошибок. Их можно устроить так, чтобы они срабатывали при заполнении пула потоков, где счётчик может не успеть, и очереди, где клиент ответов не ждёт. Изменения состояния стоит записывать в журнал, потому что поведение предохранителя часто предупреждает о более глубоких бедах. Наконец, предохранитель сбой не чинит, поэтому клиент должен решить, отказать ли в операции или применить обходной путь.
Вернись через несколько дней
Открой эти вопросы, когда материал немного забудется, и сначала ответь сам.
Ответьте, не перечитывая статью.
Перескажи без подсказок: почему один зависший поставщик может остановить исправные части системы? Начни с вызова и закончи каскадом.
Ответ. Вызов держит ресурс весь срок ожидания. Ресурсы заканчиваются, и исправные операции перестают выполняться. Клиент сам становится неотвечающим поставщиком для других.
Почему. Без связи между ожиданием и ограниченным ресурсом таймаут кажется достаточной защитой.
В хорошем ответе:- Есть ограниченный ресурс.
- Показан переход к следующей системе.
Запиши по памяти три состояния предохранителя и все переходы между ними. Что запускает каждый переход?
Ответ.
Closed: успех и неудача ниже порога оставляют состояние, неудача на пороге ведёт вOpen.Open: вызов получает ошибку, состояние прежнее; срок сброса ведёт вHalf Open.Half Open: успех ведёт вClosed, неудача вOpen.Почему. Каждый переход вызван исходом вызова или прошедшим временем.
В хорошем ответе:- Семь переходов, включая петли.
- В
Half Openведёт время, а не вызов.
Интернет-кинотеатр получает рекомендации от отдельного сервиса, и тот завис. Какой ход событий ожидать с предохранителем и что показать пользователю, когда цепь разорвана?
Ответ. Первые вызовы ждут таймаута, затем предохранитель срабатывает и отказы идут сразу, а пробы со временем вернут рекомендации. Показать можно популярное или сохранённые рекомендации.
Почему. Устаревший список здесь обходится дёшево.
В хорошем ответе:- Порядок: ожидание, срабатывание, быстрый отказ, проба.
- Обходной путь обоснован.
Счётчик с порогом 5 считает все ошибки поставщика, включая ответ «заказ не найден». Такой ответ получает примерно каждый третий клиент, вызовов 50 в секунду, поэтому пять таких ответов подряд случаются в среднем раз на 363 вызова. Что будет при исправном поставщике и как это исправить?
Ответ. Примерно каждые 7 секунд (363 / 50) предохранитель будет срабатывать при исправном поставщике и отказывать всем. Такие ответы надо исключить из неудач.
Почему. Успех стирает счётчик, но при большом потоке редкая серия всё равно случается часто. Следующий вызов такие ответы не предсказывают.
В хорошем ответе:- Ошибка отнесена к нормальным отказам.
- Назван итог: ложное срабатывание.
Таймаут 60 секунд, порог 5, 50 вызовов в секунду, 200 работников, общих на все операции. Поставщик завис. Успеет ли счётчик защитить систему? Что добавить?
Ответ. Нет. Работники кончатся через 4 секунды, а первая неудача будет только на шестидесятой секунде. Нужно отдельное ограничение на этого поставщика, например небольшой пул с разрывом цепи при его исчерпании.
Почему. Счётчик получает данные только от завершившихся вызовов.
В хорошем ответе:- Названы 4 и 60 секунд.
- Предложено ограничение одновременных вызовов.
Откуда это и где читать дальше
Статья пересказывает заметку Мартина Фаулера (Martin Fowler) Circuit Breaker от 6 March 2014 с его сайта. Фаулер благодарит Pavel Shpak, который заметил ошибку в коде примера и сообщил о ней.
Технический блог Netflix содержит много полезного о повышении надёжности систем с большим числом сервисов. Их статья о Dependency Command рассказывает о предохранителях и об ограничении пула потоков. Адрес устарел: он перенаправляет на блог Netflix на Medium.
Netflix выложили в открытый доступ Hystrix, развитый инструмент для работы с задержками и отказами в распределённых системах. Он содержит реализацию предохранителя с ограничением пула потоков.
В заметке Hystrix подан как актуальный инструмент; на ноябрь 2026 года в README, описании проекта на GitHub, указано, что он больше не развивается и находится в режиме поддержки (последний выпуск 1.5.18), а для новых проектов Netflix рекомендует активные проекты вроде Resilience4j; источник: README Hystrix.
Другие реализации паттерна с открытым кодом: на Ruby, Java, плагин для Grails (Grails Plugin), C#, AspectJ и Scala. На 7 ноября 2026 года страница плагина Grails отвечает ошибкой 404, а остальные открываются. Проверена только доступность, а не поддержка кода.
Деталь. у книги Release It! есть и второе издание 2018 года; ссылка выше ведёт на первое, 2007 года.